
Auf vektorrausch.de verlangten Bots in fünf Wochen nur bei 2,9 % der Seitenabrufe Markdown, obwohl wir die Markdown-Fassung jedem Bot anbieten. Deutlich höhere Werte entstehen leicht, sobald ein Zwischenspeicher Markdown an alle Besucher weitergibt. Für die Sichtbarkeit in KI-Antworten bleibt sauberes HTML deshalb der wichtigste Hebel.
Im September erschien bei den Kollegen von der Agentur 4eck Media aus Waren (Müritz) ein Artikel mit einer klaren Botschaft: Markdown Negotiation schlägt llms.txt. Die Idee dahinter ist bestechend. Dieselbe Adresse liefert Menschen die vollständige Website und KI-Agenten eine schlanke Textfassung ohne Navigation und Layout. Wir waren neugierig, ob wir dieselben Erfahrungen machen und ob Markdown der Nachbrenner für Agent-Readiness wird. Also haben wir ein eigenes Plugin gebaut, „Agentengerecht Markdown“. Seit dem 12.10.2026 läuft es auf vektorrausch.de.
Was 4eck gemessen hat
4eck hat 30 Tage lang die Bot-Zugriffe auf die eigene Website ausgewertet, zusammen 50.000 Abrufe. 24.293 Seiten gingen als Markdown hinaus, die llms.txt wurde im selben Zeitraum 13-mal abgerufen. Markdown machte 75,3 % aller ausgelieferten Seiten aus, bei vielen Bots lag der Anteil über 95 %.
Angeboten wird das Markdown auf zwei Wegen: per Content-Negotiation, also wenn ein Bot im Accept-Header ausdrücklich text/markdown anfordert, und über einen Link im HTML mit dem Zusatz ?format=markdown. 4eck ordnet die eigenen Zahlen vorsichtig ein. Ein Abruf sei noch keine Empfehlung, und die Daten stammen aus einer Website und einem Monat. Die Ehre der Idee gebührt den Kolleginnen und Kollegen von 4eck, sie hat uns überhaupt erst zum eigenen Versuch gebracht.
Was wir auf vektorrausch.de messen
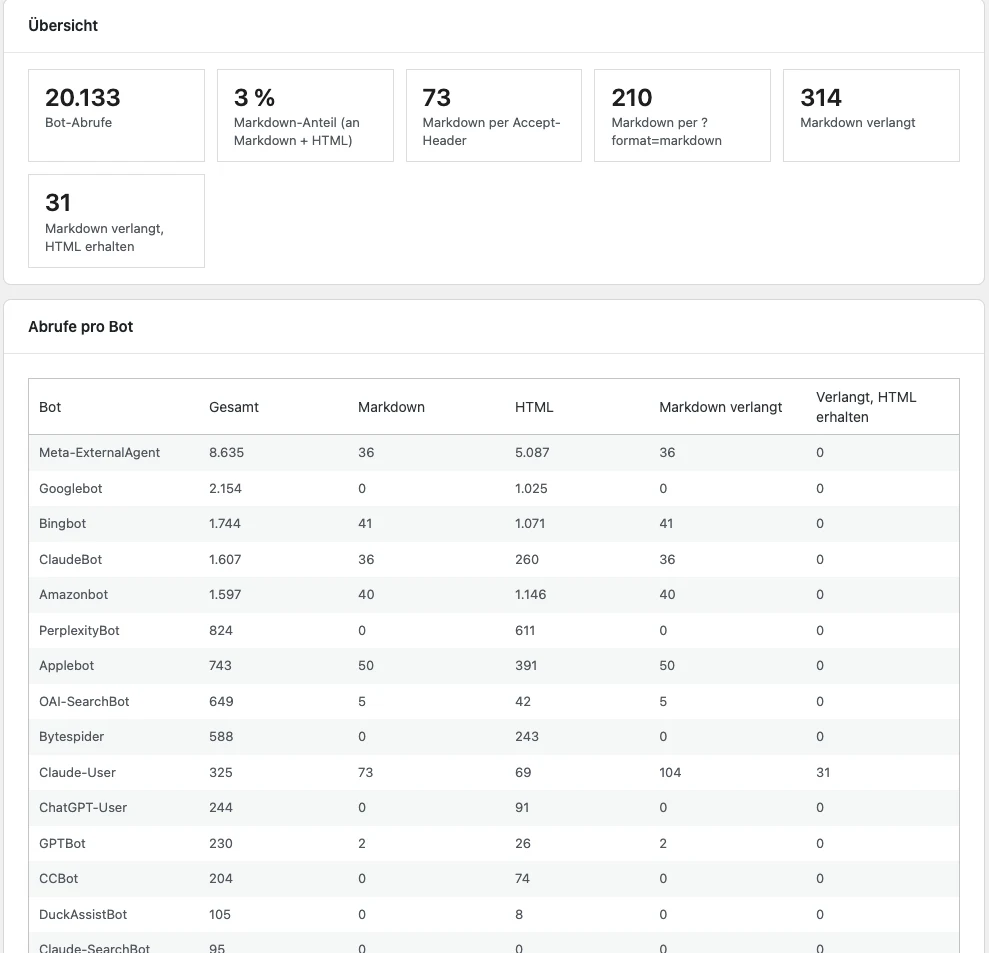
Unser Plugin zählt seit dem 12.10.2026 die Abrufe erkannter Bots, getrennt nach Bot und nach ausgeliefertem Format, und hält fest, ob ein Bot Markdown verlangt hat. Bis zum 17.11.2026 kamen 20.118 Abrufe von 20 Bots zusammen, unsere eigenen Testabrufe sind herausgerechnet. Bei 10.415 ausgelieferten Seiten verlangten Bots 301-mal Markdown, das sind 2,9 %. Die übrigen Abrufe waren Weiterleitungen, Fehlerseiten und Dateien wie robots.txt und sitemap.xml. Von den ausgelieferten Markdown-Seiten wurden 60 über den Accept-Header angefordert, 210 über den Link mit ?format=markdown. Der Anteil bei uns in der Tabelle zeigt, wie oft ein Bot Markdown verlangt hat, bezogen auf seine ausgelieferten Seiten.
| Bot | Abrufe bei uns | davon Markdown verlangt | Anteil bei uns (verlangt) | Markdown-Anteil bei 4eck (ausgeliefert) |
|---|---|---|---|---|
| Meta-ExternalAgent | 8.635 | 36 | 0,7 % | 99,7 % |
| ClaudeBot | 1.604 | 33 | 11,3 % | 97,9 % |
| Bytespider | 586 | 0 | 0 % | 95,6 % |
| ChatGPT-User | 244 | 0 | 0 % | 99,5 % |
| Claude-User | 315 | 94 | 71,2 % | 47,9 % |
| GPTBot | 230 | 2 | 7,1 % | 96,0 % |
| CCBot | 204 | 0 | 0 % | 99,4 % |
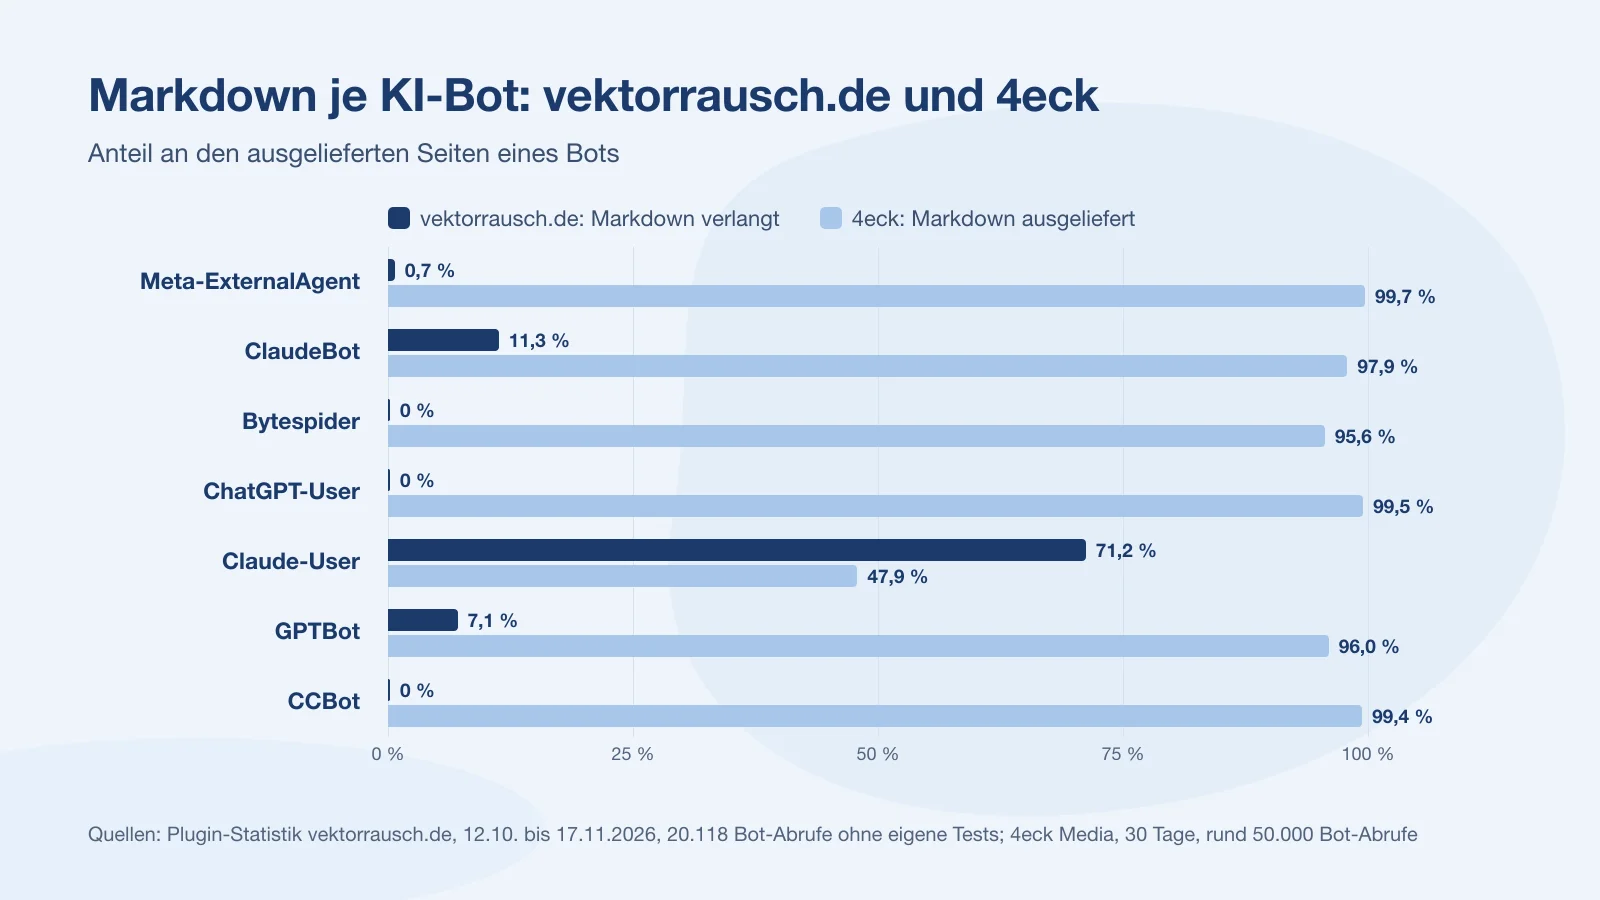
Am deutlichsten ist der Unterschied beim Crawler von Meta. Bei 4eck stammen gut 17.000 Markdown-Seiten von Meta-ExternalAgent in Version 1.1. Bei uns ist er mit 8.635 Abrufen der aktivste Bot. Er hat nur 36-mal Markdown verlangt, das sind 0,7 %. Unser Plugin liefert Markdown aus, sobald eine Anfrage text/markdown mindestens gleichrangig mit HTML anfordert oder die Adresse ?format=markdown enthält. Meta hat das nur in diesen 36 Fällen getan.
Aufschlussreich ist Claude-User. Mit diesem Abruf liest Claude eine Seite im Auftrag eines Menschen, der gerade eine Frage gestellt hat. Claude-User hat bei uns in 71,2 % seiner Seitenabrufe Markdown verlangt, bei 4eck bekam er es in 47,9 % der Fälle. Crawler wie ChatGPT-User, Bytespider und CCBot haben bei uns kein einziges Mal Markdown verlangt und bei 4eck trotzdem zu mehr als 95 % Markdown bekommen. Das passt zu dem, was wir weiter unten beim Zwischenspeicher gefunden haben.
Über die Wochen ist der Markdown-Anteil gesunken. In der ersten Woche vom 12. bis 18.10.2026 gingen 4,6 % der Seiten als Markdown hinaus, in der Woche vom 9. bis 15.11.2026 noch 1,6 %.
So messen wir, und wo die Grenzen liegen
Unsere Zahlen zeigen, welches Format das Plugin ausgeliefert hat und ob ein Bot Markdown verlangt hat. Den Accept-Header selbst speichern wir nicht, nur diese Einordnung. Anfragen, die Markdown niedriger gewichten als HTML, zählt das Plugin gesondert. Bisher gab es keine. Unsere eigenen Testabrufe mit Bot-Kennung haben wir herausgerechnet.
Bots erkennen wir am User-Agent. IP-Bereiche der Anbieter oder signierte Anfragen prüfen wir nicht, ein gefälschter User-Agent wird also mitgezählt. Unter den Abrufen fanden sich zum Beispiel Anfragen mit Meta-Kennung in Version 1.0 auf typische Scanner-Pfade wie /.env. Vermutlich steckt dahinter kein Crawler von Meta, sondern ein Scanner mit falschem Namen.
HTML-Abrufe, die ein Seiten-Cache beantwortet, bevor WordPress startet, erreichen unser Plugin nicht und fehlen in der Statistik. Der tatsächliche Markdown-Anteil liegt deshalb eher noch niedriger als gemessen.
Warum die Zahlen so weit auseinanderliegen
Den wahrscheinlichsten Grund liefert der Zwischenspeicher. Ein Server, der unter derselben Adresse mal HTML und mal Markdown ausliefert, muss dem Cache mitteilen, dass die Antwort vom Accept-Header abhängt. Dafür gibt es die Angabe Vary: Accept. Ohne sie bekommt jeder Besucher die Fassung, die zuerst gespeichert wurde.
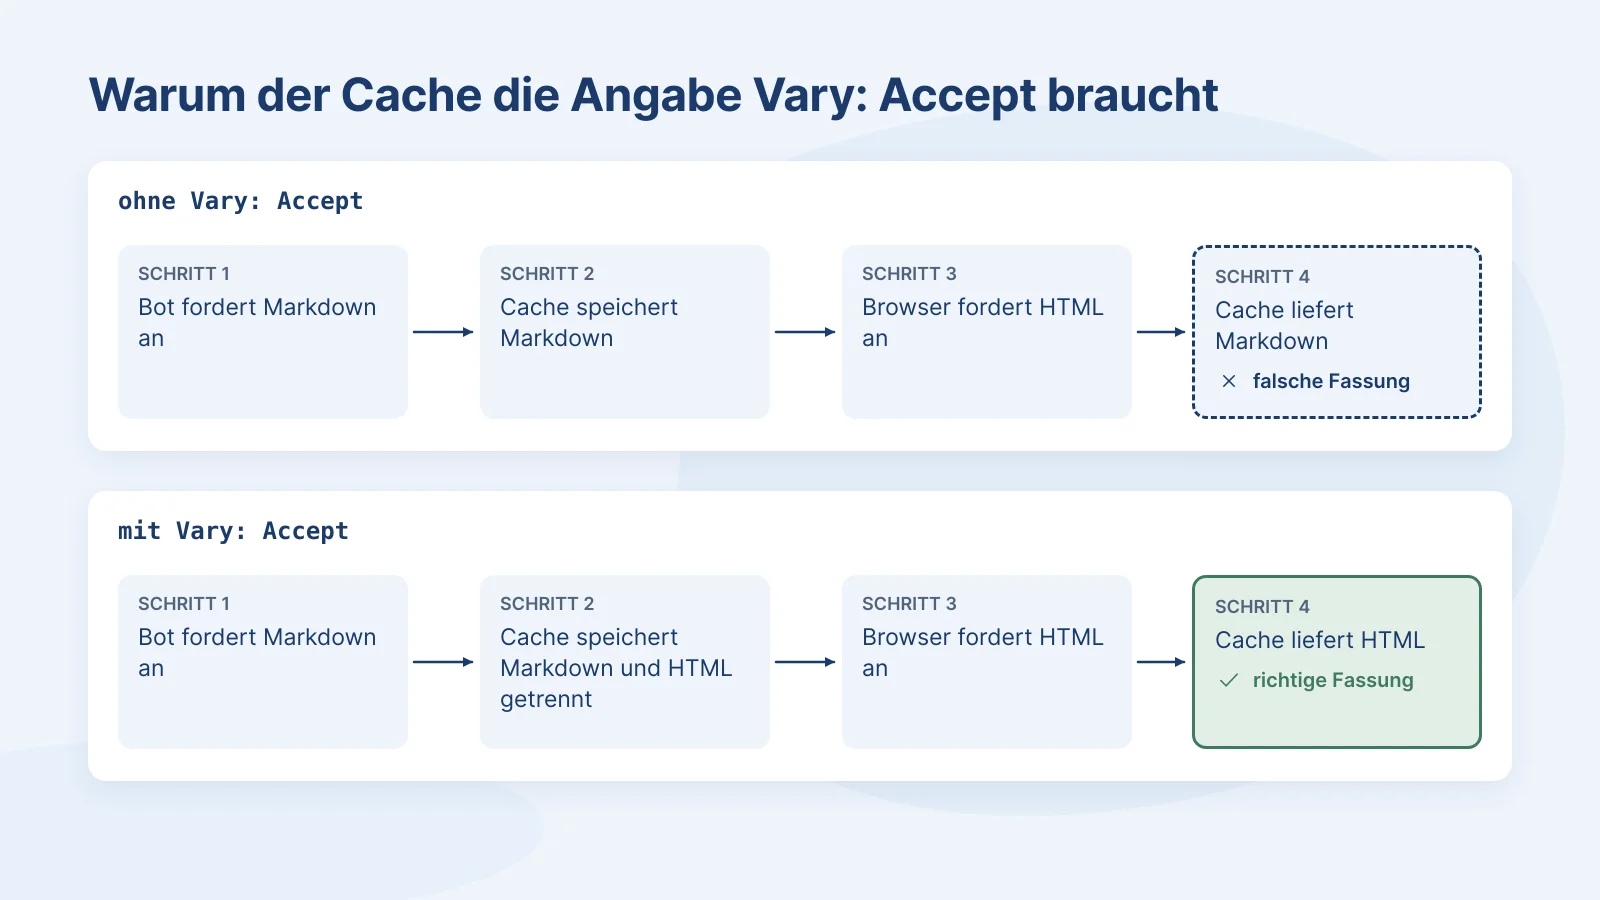
Wir haben das am 13.10.2026 auf beiden Websites ausprobiert. Auf vektorrausch.de bekam ein Browser immer HTML, ein Bot mit Markdown-Wunsch immer Markdown, auch abwechselnd und wiederholt. Auf dem 4eck-Artikel zur Markdown-Negotiation lieferte der Cache dagegen auch einem normalen Chrome-Browser die Markdown-Fassung aus, ebenso einem Bot, der gar kein Markdown verlangt hatte. Die Antwort enthielt kein Vary: Accept. HTML kam erst zurück, als ein Zusatz in der Adresse den Cache umging.
| Anfrage an den 4eck-Artikel (13.10.2026) | Ergebnis |
|---|---|
| Bot fordert Markdown an | Markdown |
| Chrome-Browser fordert HTML an | Markdown aus dem Cache |
| Bytespider ohne Formatwunsch | Markdown aus dem Cache |
| Browser mit Cache-Umgehung | HTML |
Für eine Messung macht das einen großen Unterschied. Ohne saubere Trennung zeigt das ausgelieferte Format den Zustand des Caches, nicht den Wunsch des Bots. Das gilt für jeden Zähler, auch für unseren: Er ist nur deshalb aussagekräftig, weil unser Server die Formate zuverlässig trennt. Ob der Cache die Zahlen von 4eck beeinflusst hat, können nur die Kolleginnen und Kollegen mit ihren eigenen Logs klären.
So prüfen Sie es auf Ihrer eigenen Website
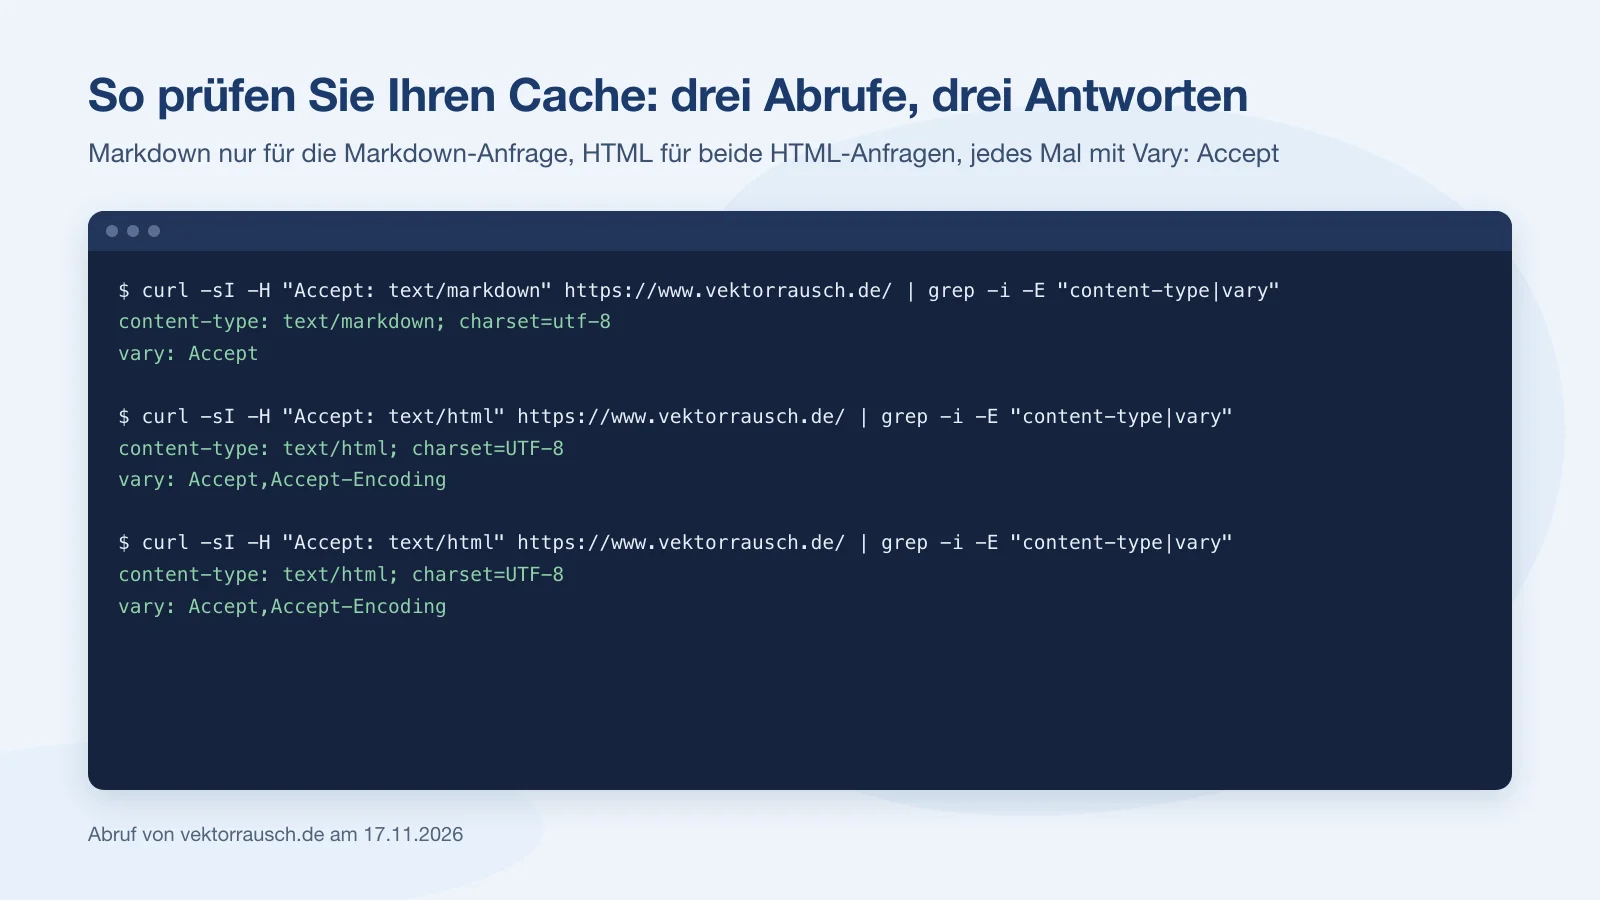
Halten Sie fest, was ein Bot anfordert, und nicht nur, was Ihr Server ausliefert. Und prüfen Sie, ob Ihr Cache die Formate auseinanderhält. Dafür reichen drei Befehle im Terminal, nacheinander ausgeführt:
curl -sI -H "Accept: text/markdown" https://www.ihre-domain.de/ | grep -i -E "content-type|vary"
curl -sI -H "Accept: text/html" https://www.ihre-domain.de/ | grep -i -E "content-type|vary"
curl -sI -H "Accept: text/html" https://www.ihre-domain.de/ | grep -i -E "content-type|vary"
Der erste Befehl sollte text/markdown zurückmelden, die beiden anderen text/html, und alle drei sollten Vary: Accept enthalten. Bei Cloudflare lässt sich die Trennung seit Juli 2026 in den Cache-Regeln einstellen, vorausgesetzt, der Server schickt Vary: Accept mit (Cloudflare-Dokumentation). Unser Plugin enthält dafür einen Selbsttest, der eine Seite wie ein Browser und wie ein Bot abruft und die Abrufe wiederholt. Erst die Wiederholung deckt einen falsch eingestellten Cache auf.
Was das für Ihre Website heißt
Die große Mehrheit der KI-Agenten liest heute HTML. Für die Sichtbarkeit in KI-Antworten zählt deshalb vor allem, wie sauber Ihre Seiten gebaut sind: klare Überschriften, Links mit lesbarem Namen, Alternativtexte und strukturierte Daten. Ein Agent liest eine Seite so, wie ein Screenreader sie für blinde Menschen vorliest. Google prüft das inzwischen in PageSpeed Insights in einer eigenen Kategorie „Agentisches Browsing“.
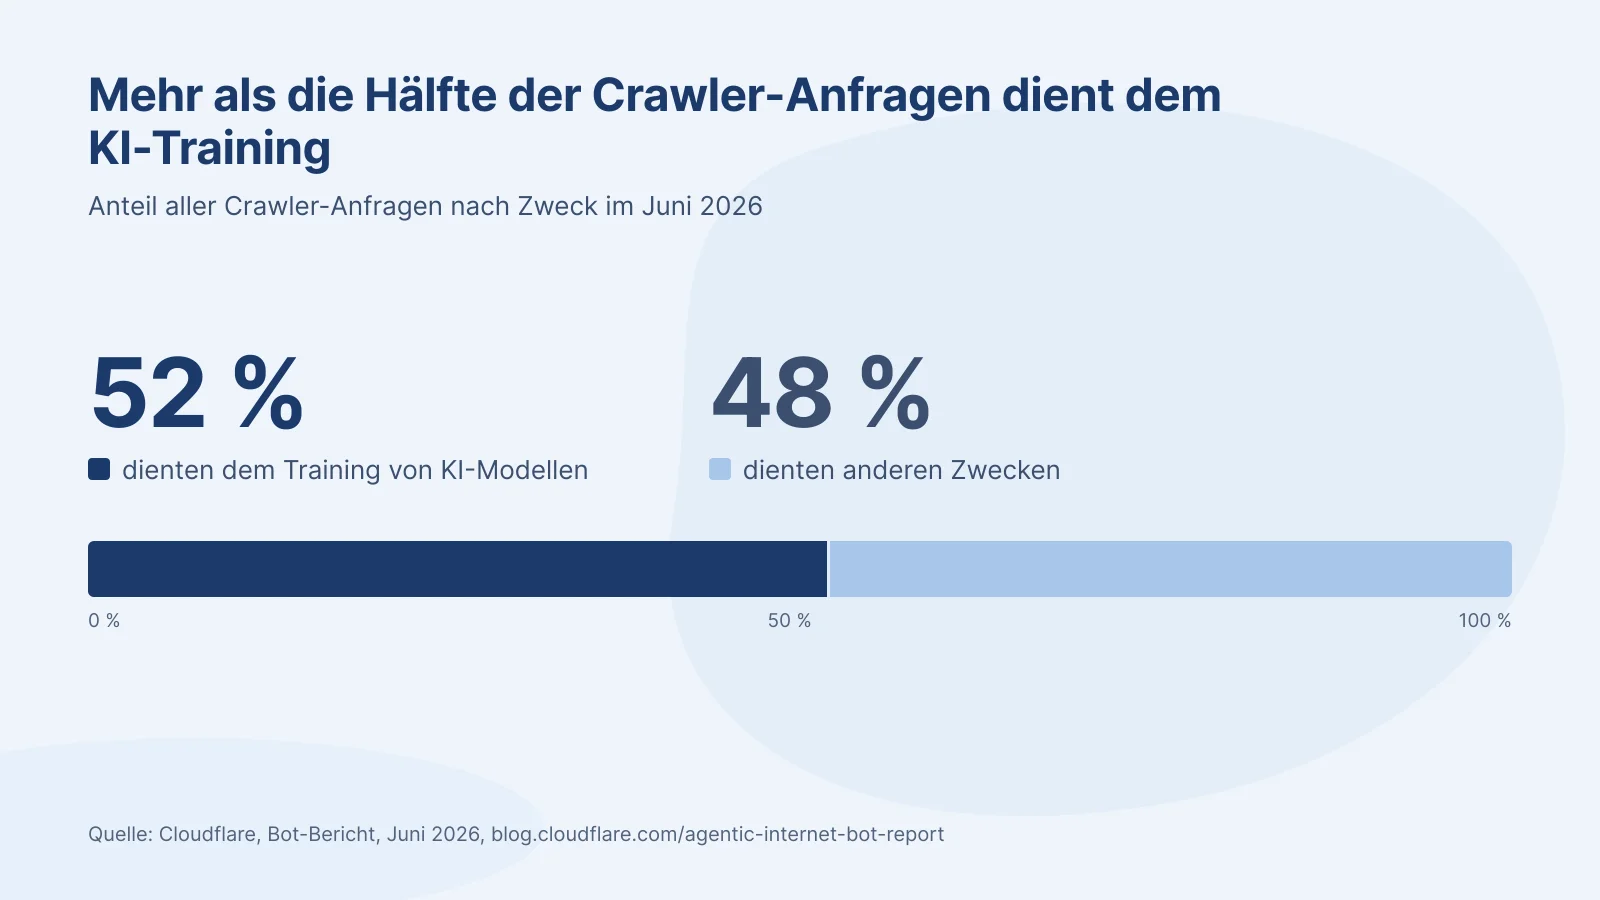
Auch die Art der Bots verdient einen zweiten Blick. Laut Cloudflare dienten im Juni 2026 52 % aller Crawler-Anfragen dem Training von KI-Modellen (Cloudflare-Bericht). Für Ihre Sichtbarkeit zählen vor allem die Agenten, die im Auftrag eines Menschen eine Frage beantworten, etwa ChatGPT-User oder Claude-User. Von ihnen kam bei uns bisher genau ein Markdown-Abruf, von Claude-User.
Eine sauber umgesetzte Markdown-Fassung schadet nicht. Unser Plugin läuft vorerst als Pilot auf vektorrausch.de und schließt die Markdown-Fassung von Suchmaschinen aus, mit einem Verweis auf die HTML-Seite als Original. Nach der Messphase entscheiden wir, ob es Teil unseres WordPress-Update-Services wird. Den größeren Hebel sehen wir aber im HTML selbst.
Ein Blick auf das Time Magazine
Wie weit getrennte Fassungen für Bots gehen können, zeigt das Time Magazine. Laut heise vom 12.08.2026 bekommen KI-Crawler dort eine Markdown-Fassung mit Werbung im Stil von Fragen und Antworten, die menschliche Leser nicht sehen. Die Anzeigen sollen in die Antworten der KI-Assistenten einfließen.
Für uns liegt hier eine klare Grenze. Die Markdown-Fassung einer Seite enthält bei uns denselben Inhalt wie die Website, nur ohne Navigation und Gestaltung. Andere Preise, andere Aussagen oder versteckte Werbung für Bots würden das Vertrauen kosten, auf das es bei KI-Antworten ankommt.
Zusatz, kein Nachbrenner
Wir wollten wissen, ob Markdown der Nachbrenner für Agent-Readiness wird. Nach fünf Wochen sieht es bei uns nach einem sinnvollen Zusatz aus, mehr nicht. Die meisten Agenten lesen weiter HTML, und dort entscheidet sich, ob Ihre Website in einer KI-Antwort vorkommt. Die Idee von 4eck war trotzdem ein Gewinn: Ohne sie hätten wir nicht so genau hingesehen.
Wie Ihre Website heute in ChatGPT, Claude, Gemini und Perplexity dasteht, zeigt der kostenlose Kurz-Check auf agentengerecht.de in wenigen Minuten. Was wir für die Sichtbarkeit Ihrer Seiten tun, steht auf der Seite SEO und GEO.
Häufige Fragen zu Markdown für KI-Agenten
Was ist Markdown-Negotiation?
Markdown-Negotiation ist ein Verfahren, bei dem dieselbe Adresse je nach Anfrage ein anderes Format liefert. Ein Browser fordert HTML an und bekommt die Seite mit Layout. Ein KI-Agent, der im Accept-Header text/markdown angibt, bekommt eine reine Textfassung ohne Navigation und Gestaltung. Der Inhalt bleibt in beiden Fassungen derselbe.
Brauche ich eine llms.txt?
Eine llms.txt ist schnell angelegt, wird aber kaum abgerufen. Bei 4eck kamen in 30 Tagen 13 Abrufe zusammen. Auf vektorrausch.de liefert der Server die Datei direkt aus, unser Plugin zählt diese Abrufe nicht mit. Wir halten die Datei für eine Kleinigkeit, die wenig kostet, und versprechen uns davon keine messbare Wirkung auf die Sichtbarkeit in KI-Antworten.
Schadet eine Markdown-Fassung meiner Sichtbarkeit bei Google?
Eine korrekt umgesetzte Markdown-Fassung schadet der Sichtbarkeit bei Google nicht. Wir schließen sie mit noindex von Suchmaschinen aus und verweisen per Canonical-Angabe auf die HTML-Seite als Original. So entsteht kein doppelter Inhalt, und Google bewertet weiter nur die HTML-Seite, die auch Ihre Besucher sehen.
Wie prüfe ich, ob mein Cache die Formate trennt?
Sie rufen dieselbe Seite einmal mit Accept: text/markdown und danach zweimal mit Accept: text/html ab. Kommt beim zweiten oder dritten Abruf Markdown zurück, gibt Ihr Cache die zuerst gespeicherte Fassung an alle Besucher weiter. Zusätzlich sollte jede Antwort die Angabe Vary: Accept enthalten.
Welche Bots fordern bei vektorrausch.de Markdown an?
Zwischen dem 12.10. und dem 17.11.2026 haben acht von 20 erkannten Bots mindestens einmal Markdown verlangt. Am häufigsten war es Claude-User mit 94 Anfragen, gefolgt von Applebot, Bingbot, Amazonbot, Meta-ExternalAgent und ClaudeBot mit je 33 bis 50. Googlebot, PerplexityBot, ChatGPT-User, Bytespider und CCBot haben in dieser Zeit kein einziges Mal Markdown verlangt.
Transparenzhinweis: Für diesen Beitrag haben wir KI zur Recherche und für Rohfassungen einzelner Abschnitte eingesetzt. Fachliche Aussagen, Zahlen und Empfehlungen stammen von uns. Redaktionell geprüft und freigegeben von Tobias Herold. Wie wir KI einsetzen und wann eine Kennzeichnung Pflicht ist, steht auf unserer Seite zur KI-Transparenz.